



Un estudio publicado el 18 de agosto de 2026 en la revista científica PNAS Nexus, con el título Like humans, language models demonstrate face-to-character biases (Al igual que los humanos, los modelos de lenguaje muestran sesgos basados en la relación entre el rostro y el personaje), demuestra que los grandes modelos de lenguaje (LLM) reproducen de forma sistemática los sesgos humanos al atribuir rasgos de personalidad –como confianza o competencia– a partir de fotografías de rostros.
Estos sesgos influyen en juicios de gran trascendencia, como atribuir a una persona la comisión de delitos graves o adoptar decisiones favorables con un impacto significativo, por ejemplo, en procesos de selección laboral o en la obtención de créditos.
Sesgos humanos
El estudio parte de la siguiente imagen:
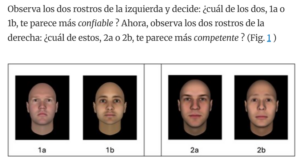
Las investigaciones muestran que el rostro 1b, en relación con el 1a, se suele juzgar como “más confiable”. De manera similar, el rostro 2a, en relación con el 2b, tiene a considerarse como “más competente”.
Los autores realizaron un total de 13 experimentos que suman casi 8.000 ensayos. GPT-4o seleccionó el rostro que se esperaría según las calificaciones humanas el 74,88 % de las veces. Los modelos más recientes (GPT-5, Gemini 3 Flash Preview y Claude Sonnet 4.5) mostraron un grado de sesgo igual o superior.
Los autores consideran que lo más probable es que este sesgo, aunque relacionado con imágenes, se haya aprendido a partir del lenguaje natural. Los LLM se entrenan con grandes volúmenes de texto procedentes de Internet. Como esos datos reflejan opiniones, estereotipos y errores humanos, el modelo los asimila. Lo preocupante es que no se limita a copiarlos, sino que los amplifica, lo que exige un rediseño de los marcos de alineación, transparencia y supervisión humana efectiva.
Los resultados no son anecdóticos: revelan una falla estructural en los mecanismos de alineación, que no logran alcanzar la neutralidad deseada, por ejemplo, eliminando estereotipos raciales o de género.
Soluciones posibles
Aunque los autores no formulan propuestas concretas para corregir estos sesgos, cabría considerar las siguientes medidas:
Una solución para eliminar o mitigar los sesgos consistiría en restringir de forma estricta el uso de sistemas de IA que realicen inferencias sobre el carácter o la idoneidad de una persona a partir de sus rasgos faciales, especialmente en ámbitos de alto riesgo como el empleo, la justicia, la inmigración o el acceso al crédito y a los seguros. Solo deberían admitirse cuando se demuestre, de forma fehaciente, su validez predictiva y la ausencia de sesgos discriminatorios.
Asimismo, sería conveniente reforzar las exigencias de transparencia. Los proveedores deberían documentar y hacer público en qué medida las representaciones visuales influyen en las valoraciones automatizadas sobre el carácter o la idoneidad de las personas.
Por último, resulta crucial garantizar una supervisión humana efectiva, y no meramente formal. La intervención humana debe permitir revisar el resultado del sistema y descartar o, en su caso, corregir cualquier sesgo facial identificado.
Conclusión
La idea de una IA justa no será realidad mientras los modelos sigan repitiendo los errores de pensamiento tradicionales de los humanos.


